電磁界解析ソフトウェア

電磁界解析ソフトウェア
OpenMP並列ソルバーへのFSAI-CG法の導入
- TOP >
- 機能別解析例・解析技術(一覧) >
- OpenMP並列ソルバーへのFSAI-CG法の導入
概要
電磁界解析で現れる大規模な疎行列連立一次方程式に対して、EMSolutionではOpenMP対応のBlock-ICCG法を実装してきました。今回、新しい選択肢としてFSAI-CG法を実装し、既存Block-ICCG法との比較を行いました。
FSAIは、Factorized Sparse Approximate Inverse の略称です。疎行列の 逆行列を直接求めるのではなく、疎な近似逆行列を構築して前処理に使用します。 今回の実装では、概念的に
$M^{-1} ≈ Z^T D^{-1} Z$
という形の近似逆行列を使用します。反復中は、$Z$ と $Z^T$ による疎行列とベクトルの積を実行します。疎行列とベクトルの積は並列処理がしやすいのが特長です。
Block-ICCG法との違い
Block-ICCG法は、IC分解で得られる三角行列を使った前進代入と後退代入を、スレッドごとのBlockに分けて実行します(前進代入,後退代入は並列処理が難しいため)。Block分割によって高い並列性を得られますが、Block分割したことによる範囲外の行列要素の情報が損なわれること、スレッド数や並列実行順序によって数値的な経路が変わることなどから、一般的に知られているように今回の非線形解析でも反復回数が増加する傾向が見られました。
一方、FSAIはsetup時に構築した近似逆行列を全スレッドで共有して適用します。同じ線形問題に対して同じ前処理と演算順序が保たれる理想的な条件では、スレッド数を変えても反復回数は変わらないことが期待されます。実際の非線形解析では丸め誤差によって非線形経路が変化するため完全に同じとは限りませんが、今回のFSAIではBlock-ICCGより反復回数が安定していました。
解説
今回検証に用いた解析マシンは,Azure Virtual Desktop で用意した32コアマシンになります。並列数は,
- OpenMPスレッド数: 1, 2, 4, 8, 16, 32
で行いました。 以下の結果に示すグラフの計算時間は、メッシュ読み込みや出力を含む全計算時間です。 反復性能の比較には、solver内部の計算時間を対象としています。
今回のProblem20とmotor D1modelの比較は、いずれも非線形解析で実施しています。したがって、各時刻・各反復での行列更新、初期値、非線形収束経路が、ソルバーの反復回数と総計算時間に影響します。なお、線形問題を同じ行列・同じ右辺で解く場合は、非線形経路による差がなくなるため、FSAI-CGの反復回数はスレッド数に対してより一定になることが期待されます。
Problem20は非線形性が比較的強くないため、今回の傾向、すなわちFSAI-CGの並列スケーリングは良好でも前処理の強さが不足すると総時間でBlock-ICCGに及ばない、という関係は線形解析でも大きくは変わらないと推測できます。ただし、これは行列と右辺を固定した線形計算で確認すべき推測であり、線形解析の実測結果そのものではありません。
一方、motor D1modelはIPMSMであり、ロータコアのブリッジ、すなわちフラックスバリアとロータ表面の間の細い領域で磁気飽和が生じやすい構造です。そのため、非線形反復に伴う局所的な材料特性・行列の変化が大きく、今回のD1model結果は単なる線形ソルバー性能だけでなく、飽和を含む非線形解析での挙動を示しています。この結果を線形解析へ直接一般化することは避け、線形版では別途、固定行列に対する反復回数、前処理強度、並列スケーリングを確認する必要があります。
Problem20
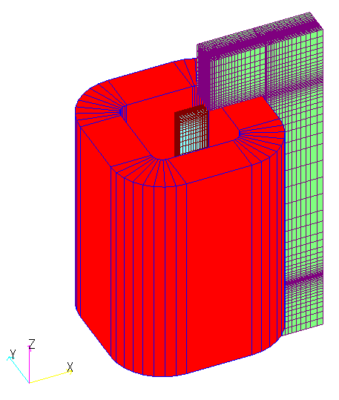
Fig.1 Problem20 細メッシュモデル
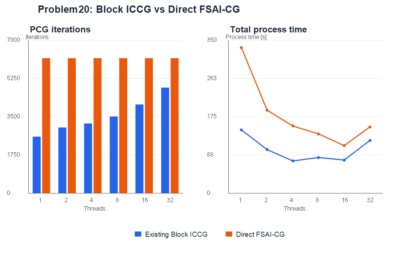
Fig.2 Problem20 反復回数と計算時間
| Threads | Block-ICCG iterations | FSAI-CG iterations | Block time [s] | FSAI time [s] |
|---|---|---|---|---|
| 1 | 2,592 | 6,183 | 145.028 | 332.515 |
| 2 | 3,011 | 6,183 | 100.393 | 189.842 |
| 4 | 3,195 | 6,182 | 73.981 | 153.654 |
| 8 | 3,516 | 6,183 | 81.696 | 136.406 |
| 16 | 4,066 | 6,182 | 75.903 | 108.824 |
| 32 | 4,834 | 6,182 | 120.525 | 151.610 |
Problem20ではFSAI-CGの1スレッドから16スレッドまでの速度向上率は3.06倍で、Block-ICCGの1.91倍を上回りました。しかし、16スレッドでFSAI-CGは6,182回、Block-ICCGは4,066回の反復を必要としています。 1反復あたりのコストはFSAI-CGが12.290 ms、Block-ICCGが12.551 msでほぼ同等です。そのため、総計算時間はFSAI-CGが108.824秒、Block-ICCGが75.903秒となり、Block-ICCGが有利でした。
この結果は、FSAIの並列スケーリングが悪いことを意味しません。主な差は前処理の強さです。今回のRelease CSVでは診断出力を最小化しているため、accel factorの値は直接記録されていません。過去の診断結果と比較すると、Problem20はIC分解から得られるaccel factorが小さい条件に対応し、FSAIの近似前処理がBlock-ICCGほど強くならなかった可能性があります。このfactor に関する説明は、今回のCSVの直接計測値ではなく、過去の診断結果に基づく解釈です。
Problem20の考察
- FSAI-CGはスレッド数を増やしたときの速度向上率が高い。
- FSAI-CGの1反復コストはBlock-ICCGと同程度である。
- 反復数が約1.5~2.4倍に増えるため、総計算時間ではBlock-ICCGが有利である。
- 32スレッドでは両方式とも16スレッドより遅くなり、メモリ帯域や同期の影響が現れている。
motor D1model 3D
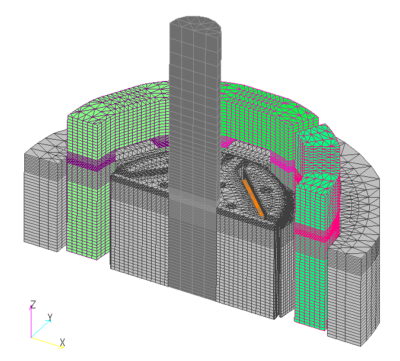
Fig.3 三次元D1model メッシュモデル
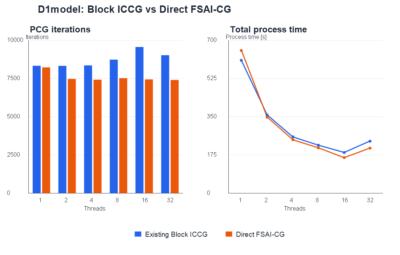
Fig.4 三次元D1model 反復回数と計算時間
| Threads | Block-ICCG iterations | FSAI-CG iterations | Block time [s] | FSAI time [s] |
|---|---|---|---|---|
| 1 | 8,334 | 8,232 | 608.008 | 653.677 |
| 2 | 8,333 | 7,475 | 358.915 | 348.745 |
| 4 | 8,362 | 7,425 | 257.783 | 244.826 |
| 8 | 8,737 | 7,529 | 219.723 | 208.355 |
| 16 | 9,564 | 7,444 | 187.353 | 163.259 |
| 32 | 9,029 | 7,410 | 238.588 | 207.002 |
D1modelでは、1スレッド時の反復数がBlock-ICCG 8,334回、FSAI-CG 8,232回とほぼ同じでした。16スレッドではBlock-ICCGの反復数が9,564回まで増加する一方、FSAI-CGは7,444回でした。
16スレッドの計算時間はFSAI-CGが163.259秒、Block-ICCGが187.353秒で、FSAI-CGが12.9%高速でした。1スレッドに対する速度向上率も、FSAI-CGが4.00倍、Block-ICCGが3.25倍で、FSAI-CGの方が高い結果です。
このモデルでは、FSAI-CGの反復数が1スレッド時点で既存法とほぼ同じであり、スレッド数を増やしても安定しています。過去の診断・factor sweepの結果からは、accel factorが約1.2程度となる有利な条件に近い可能性があります。ただし、この値も今回のRelease CSVには含まれていないため、factorそのものの実測値ではなく、反復数と過去の診断結果からの解釈です。
D1modelの考察
- FSAI-CGはBlock-ICCGと同等以下の反復数で計算できた。
- 1反復あたりのコストも、16スレッドではFSAI-CG 13.540 ms、Block-ICCG 14.202 msである。
- 反復数と1反復コストの両方が有利になり、総時間でもFSAI-CGが上回った。
- 最速スレッド数は両方式とも16で、32スレッドでは速度が低下した。
まとめ
今回の比較では、FSAI-CGはBlock-ICCGより高い並列スケーリングを示しました。 ただし、FSAI-CGが常に速いわけではありません。Problem20では反復数が多く、1反復あたりのコストは同程度でも総計算時間はBlock-ICCGが短くなりました。 一方、D1modelでは反復数が安定し、16スレッドでFSAI-CGがBlock-ICCGを上回りました。
したがって、ソルバーの選択は次のように整理できます。
- 反復数が少なく、数スレッドで計算するモデルではBlock-ICCGが有利になりやすい。
- スレッド数を増やしたときにBlock-ICCGの反復数が増加するモデルでは、FSAI-CGが有利になりやすい。
- FSAI-CGは、行列特性とaccel factorが良好な条件で、並列スケーリングの利点を総時間へ反映しやすい。
- accel factorが1.2を超えることを、すべてのモデルに適用できる普遍的な判定基準とはみなさない。今回の値は経験的な目安であり、モデルごとの診断が必要である。
- 32スレッドでは両方式とも性能が低下したため、物理コア数、メモリ帯域、NUMA配置、OpenMP affinityを含めた確認が必要である。
今回の結果からは、Block-ICCGとFSAI-CGを競合する単一方式として扱うよりも、 モデル規模、行列特性、スレッド数に応じて選択できる二本立てにすることが 実用的です。
使用方法
使用方法は, EMSolutionDoc をご参照ください。
この先は会員の方のみご覧いただけます。
機能別解析例
収束特性改善、高速化手法
- OpenMP並列ソルバーへのFSAI-CG法の導入
- INIT OPTIONの効果
- 非線形オプション比較
- 収束条件と解析精度
- 扁平四面体要素の問題点とその解決法
- 節点二次辺一次要素
- 六面体要素と四面体要素の接合
- 扁平・扁長要素の収束性の改善
- 周期的に印加される磁場に対する解の収束性
- 時間周期問題の定常解への高速収束
- 簡易版時間周期法による誘導電動機の定常解析
- 多相交流簡易EEC法による回転機の定常解析
- 時間周期条件を利用したdq軸座標系でのTP-EEC法(dq-TP-EEC法)
- 変形ポテンシャル領域に配置する外部磁場電流ソースのICCG法収束性に対する影響
- OpenMPによる並列計算機能
- 収束条件変更のリスタート解析
- 定常周期性を利用した反復計算時の初期値設定
キーワード

©2020 Science Solutions International Laboratory, Inc.
All Rights reserved.